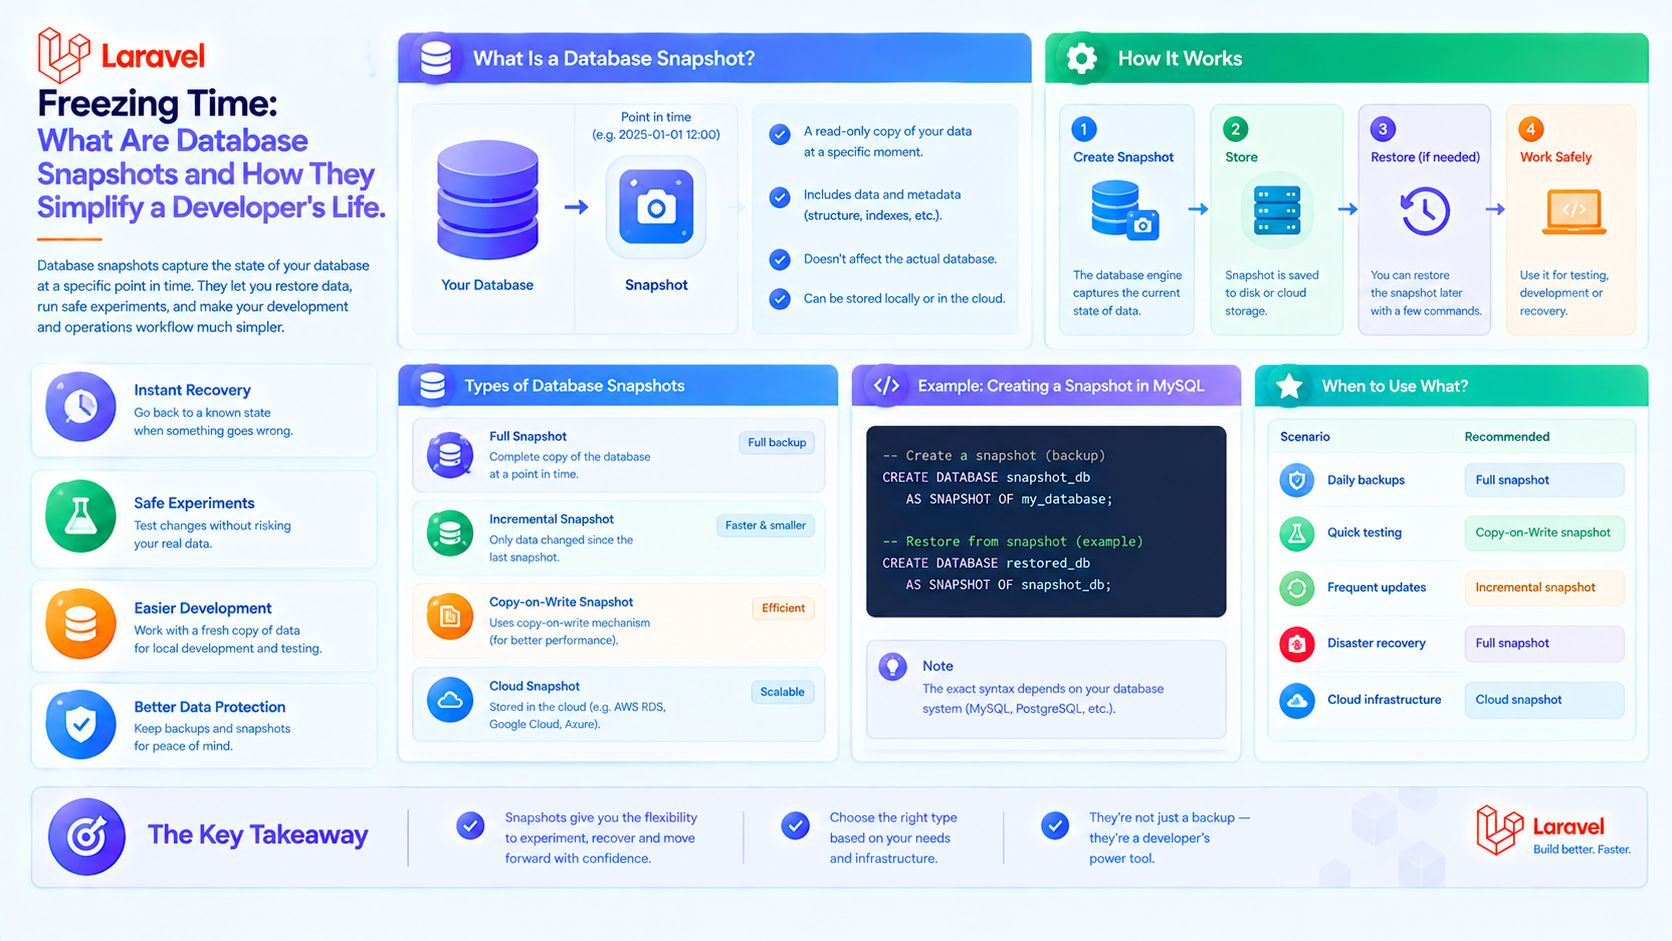
Congelare il tempo: cosa sono gli snapshot del database e come semplificano la vita di uno sviluppatore
Se lavori con i database, specialmente nel contesto di un complesso Domain-Driven Design (DDD), della programmazione event-driven o dell'analytics, probabilmente hai affrontato questo problema: come lavorare in modo efficiente con un oggetto il cui stato cambia decine di volte?
Immagina un'entità Order. Attraversa un ciclo di vita: creata → pagata → spedita → consegnata → restituita. Ogni stato è un cambiamento nel database. La cronologia delle modifiche può essere enorme. Ma cosa succede se devi:
- Ripristinare lo stato dell'ordine a una data specifica?
- Analizzare come è cambiato il suo prezzo totale nel tempo?
- Ottimizzare le query per un aggregato con una struttura complessa e profonda?
È qui che viene in soccorso il pattern Snapshot.
Cos'è uno Snapshot?
Uno Snapshot è una copia immutabile dello stato di un oggetto (un aggregato in termini di DDD) in un momento specifico nel tempo. Non è un registro delle modifiche (delta), ma una "fotografia" completa di tutti i dati importanti dell'oggetto in quel momento.
Analogia della vita reale: È come salvare una copia completa di un documento Contract_v1.2_final_updated_2024-12-01.docx prima di apportare modifiche. Puoi sempre tornare a quella versione esatta.
Perché sono necessari? 3 ragioni chiave
- Registro storico e audit. Il caso d'uso più ovvio. Puoi sapere con precisione qual era il saldo di un utente, la composizione di un ordine o il testo di un articolo esattamente un mese fa. Questo è critico per i sistemi finanziari e i sistemi con requisiti di audit legale (ad esempio, GDPR, SOX).
- Boost delle prestazioni (Event Sourcing). Nell'architettura Event Sourcing, lo stato di un oggetto viene ricreato applicando sequenzialmente tutti gli eventi dalla sua cronologia (OrderCreated, ItemAdded, OrderPaid). Se ci sono migliaia di eventi, riprodurli tutti a ogni query è costoso. La soluzione: salvare periodicamente uno snapshot dell'aggregato (versione #100, #200, ecc.). Per ripristinare lo stato più recente, carichi l'ultimo snapshot (#300) e applichi solo gli eventi successivi (#301–#350). Questo riduce drasticamente il carico.
- Cattura puntuale per il reporting. Per costruire un report analitico (ad esempio, "Ricavi dell'ultimo trimestre"), hai bisogno di dati fissati alla fine del periodo. L'uso degli snapshot garantisce che le modifiche successive non distorcano il quadro storico.
Come lavorare con loro? Pratica con Laravel (con Eloquent)
Implementiamo un semplice sistema di snapshot per un'entità Invoice.
1. Struttura del database
2. Modello e creazione dello snapshot
3. Utilizzo nel codice
Considerazioni importanti e punti chiave
- Profondità dei dati: Decidi cosa entra nello state. Solo i campi dell'aggregato o anche i dati correlati (ad esempio, il nome del cliente). Quest'ultimo semplifica la lettura ma duplica i dati.
- Frequenza: Gli snapshot possono essere creati su eventi (prima del pagamento), su pianificazione (giornaliero) o per versione (ogni N modifiche).
- Archiviazione: Il JSON nel database è comodo per oggetti complessi. Per l'analytics, gli snapshot possono essere inviati a un archivio separato (ad esempio, un Data Warehouse).
- Strumenti: Per Laravel, pacchetti come spatie/laravel-activitylog facilitano il logging, e orangehill/iseed aiuta con il seeding, ma per gli snapshot un'implementazione personalizzata spesso si adatta meglio alle esigenze specifiche.
In sintesi: Gli snapshot sono un pattern potente per lavorare con il tempo nella tua applicazione. Trasformano il tuo database da un archivio statico dello "stato attuale" in una macchina del tempo per i tuoi dati, fornendo auditabilità, prestazioni e affidabilità.