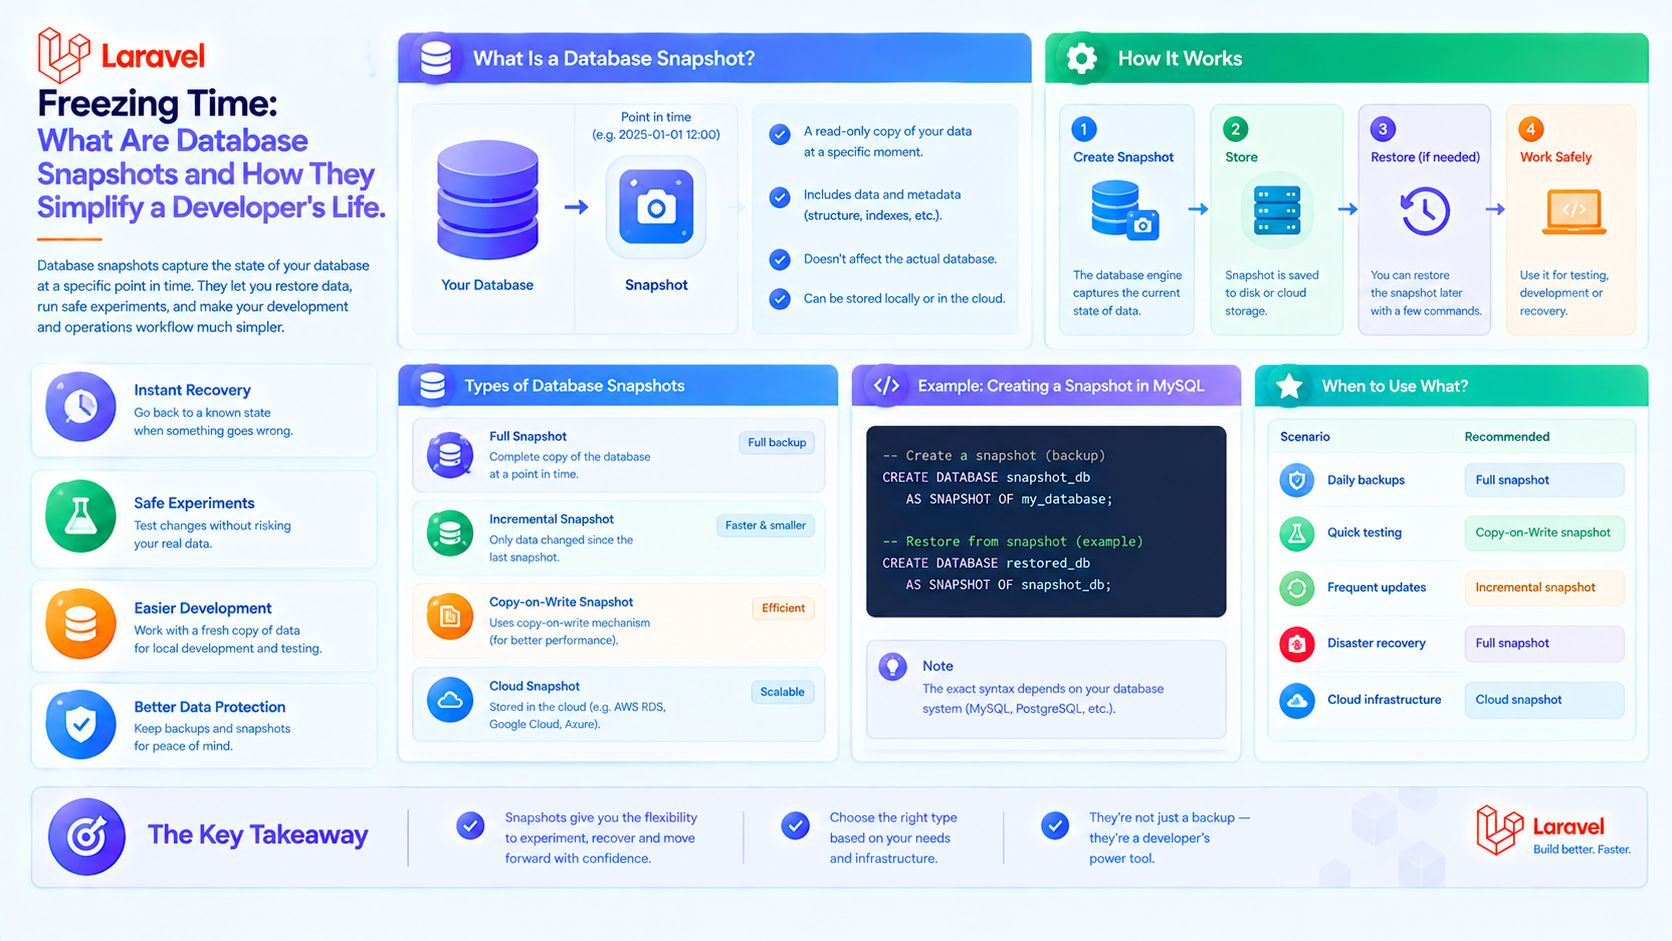
Congelar el tiempo: qué son los snapshots de base de datos y cómo simplifican la vida del desarrollador
Si trabajas con bases de datos, especialmente en el contexto de un Domain-Driven Design (DDD) complejo, programación orientada a eventos o analítica, probablemente te hayas enfrentado a este problema: ¿cómo trabajar de forma eficiente con un objeto cuyo estado cambia decenas de veces?
Imagina una entidad Order. Atraviesa un ciclo de vida: creada → pagada → enviada → entregada → devuelta. Cada estado es un cambio en la base de datos. El historial de cambios puede ser enorme. Pero ¿qué pasa si necesitas:
- Restaurar el estado del pedido en una fecha específica?
- Analizar cómo cambió su precio total con el tiempo?
- Optimizar las consultas para un agregado con una estructura compleja y profunda?
Aquí es donde entra en juego el patrón Snapshot.
¿Qué es un Snapshot?
Un Snapshot es una copia inmutable del estado de un objeto (un agregado en términos de DDD) en un momento específico en el tiempo. No es un registro de cambios (delta), sino una «fotografía» completa de todos los datos importantes del objeto en ese momento.
Analogía de la vida real: Es como guardar una copia completa de un documento Contract_v1.2_final_updated_2024-12-01.docx antes de hacer ediciones. Siempre puedes volver a esa versión exacta.
¿Por qué son necesarios? 3 razones clave
- Registro histórico y auditoría. El caso de uso más obvio. Puedes saber con precisión cuál era el saldo de un usuario, la composición de un pedido o el texto de un artículo hace exactamente un mes. Esto es crítico para sistemas financieros y sistemas con requisitos de auditoría legal (por ejemplo, GDPR, SOX).
- Mejora del rendimiento (Event Sourcing). En la arquitectura Event Sourcing, el estado de un objeto se recrea aplicando secuencialmente todos los eventos de su historial (OrderCreated, ItemAdded, OrderPaid). Si hay miles de eventos, reproducirlos todos en cada consulta es costoso. La solución: guardar periódicamente un snapshot del agregado (versión #100, #200, etc.). Para restaurar el estado más reciente, cargas el último snapshot (#300) y aplicas solo los eventos posteriores (#301 a #350). Esto reduce drásticamente la carga.
- Captura puntual para informes. Para construir un informe analítico (por ejemplo, «Ingresos del último trimestre»), necesitas datos fijados al final del período. El uso de snapshots garantiza que los cambios posteriores no distorsionen la imagen histórica.
¿Cómo trabajar con ellos? Práctica con Laravel (con Eloquent)
Implementemos un sistema de snapshots sencillo para una entidad Invoice.
1. Estructura de la base de datos
2. Modelo y creación del snapshot
3. Uso en el código
Consideraciones importantes y conclusiones
- Profundidad de datos: Decide qué entra en el state. Solo los campos del agregado o también datos relacionados (por ejemplo, el nombre del cliente). Lo último simplifica la lectura pero duplica datos.
- Frecuencia: Los snapshots pueden crearse por eventos (antes del pago), por programación (diario) o por versión (cada N cambios).
- Almacenamiento: JSON en la base de datos es conveniente para objetos complejos. Para analítica, los snapshots pueden enviarse a un almacenamiento separado (por ejemplo, un Data Warehouse).
- Herramientas: Para Laravel, paquetes como spatie/laravel-activitylog facilitan el logging, y orangehill/iseed ayuda con el seeding, pero para los snapshots una implementación personalizada suele adaptarse mejor a necesidades específicas.
En resumen: Los snapshots son un patrón poderoso para trabajar con el tiempo en tu aplicación. Transforman tu base de datos de un almacén estático del «estado actual» en una máquina del tiempo para tus datos, proporcionando auditabilidad, rendimiento y fiabilidad.